
Một chiếc laptop 16 GB nạp gọn mô hình ngôn ngữ 8 tỷ tham số ở định dạng lượng tử hóa, song lập tức nghẽn khi bạn kéo dài ngữ cảnh hội thoại. Nguyên nhân nằm ở chỗ bộ nhớ hệ thống phải gánh đồng thời trọng số mô hình, vùng đệm ngữ cảnh và tiến trình của hệ điều hành. Muốn biết cần trang bị RAM bao nhiêu cho tác vụ trí tuệ nhân tạo cục bộ, bạn phải tính cả kích thước mô hình lẫn dung lượng ngữ cảnh mà công cụ llama.cpp chiếm dụng trên thực tế trước khi xuống tiền mua phần cứng.
Cơ chế llama.cpp nạp trọng số GGUF vào bộ nhớ hệ thống
Khi bạn khởi chạy một mô hình ngôn ngữ lớn cục bộ qua llama.cpp, toàn bộ trọng số ở định dạng GGUF được nạp trực tiếp vào bộ nhớ để phục vụ tính toán. Bạn có thể hình dung tệp mô hình như một cuốn từ điển dày, còn dung lượng khả dụng chính là diện tích mặt bàn. Câu hỏi RAM bao nhiêu vì thế bắt đầu từ việc tệp mô hình cần bao nhiêu chỗ ngồi, bởi mặt bàn quá hẹp sẽ khiến tốc độ tạo phản hồi suy giảm rõ rệt.
Sai lầm phổ biến là mặc định dung lượng tệp tải về bằng đúng lượng bộ nhớ cần thiết. Trên thực tế, ngoài trọng số cố định, hệ thống còn phải phân bổ chỗ cho KV cache lưu ngữ cảnh, vùng đệm tính toán trung gian cùng các tiến trình nền. Vì vậy khi ước lượng RAM bao nhiêu là đủ, bạn phải cộng cả phần đệm này, bởi càng trò chuyện dài thì KV cache do llama.cpp cấp phát càng phình nhanh vượt xa kích thước tệp gốc.
Khi bộ nhớ khả dụng cạn kiệt, hệ thống phải mượn ổ cứng làm bộ nhớ ảo hoặc kích hoạt cơ chế offload luân phiên giữa các linh kiện. Việc di chuyển dữ liệu liên tục tạo ra hiện tượng nghẽn cổ chai, khiến máy phản hồi chậm và thời gian sinh từ kéo dài. Đây là lý do việc xác định RAM bao nhiêu ngay từ đầu quyết định trải nghiệm nhiều hơn cả tốc độ vi xử lý.
Cần RAM bao nhiêu cho từng cỡ mô hình ngôn ngữ
Với nhu cầu nhập môn và trải nghiệm mô hình cỡ nhỏ, câu trả lời RAM bao nhiêu bắt đầu từ mức 16 GB, vốn là ngưỡng tối thiểu trên dòng máy phổ thông. Mô hình Llama 3.1 8B ở định dạng Q4_K_M có tệp xấp xỉ 4,9 GB, nạp gọn vào bộ nhớ và chừa chỗ cho vài ứng dụng văn phòng. Nếu bạn vừa chạy mô hình vừa mở nhiều tab trình duyệt, mức 16 GB nhanh chóng đầy, giống tình huống trong bài Vì sao 16GB RAM chạy chatbot mượt mà tạo ảnh lại hụt hơi?
| Cỡ mô hình và định dạng | Bộ nhớ chiếm dụng | Mức RAM khuyến nghị |
|---|---|---|
| Llama 3.1 8B Q4_K_M | Tệp 4,9 GB cộng đệm ngữ cảnh | 16 GB, ngữ cảnh ngắn |
| gpt-oss 20B Q4 | 14,9 tới 17,9 GB theo ngữ cảnh 8K tới 131K | 32 GB |
| Llama 3.1 70B Q4_K_M | Trọng số chiếm 43,1 GB | 64 GB |
| gpt-oss 120B Q4 | 64,0 tới 68,5 GB theo ngữ cảnh | 96 tới 128 GB |
Mức 32 GB là điểm cân bằng lý tưởng cho lập trình viên và nhóm bán chuyên khi cần chạy mô hình tầm trung. Mô hình gpt-oss 20B định dạng Q4 tiêu tốn khoảng 14,9 GB ở ngữ cảnh 8K, tăng lên 15,5 GB tại 32K và chạm 17,9 GB khi mở rộng tới 131K. Nếu bạn phân vân RAM bao nhiêu cho tác vụ lập trình hằng ngày, con số 32 GB giúp nạp trọn tài liệu dài mà vẫn giữ đa nhiệm ổn định suốt buổi.
Khi cần vận hành mô hình quy mô lớn phục vụ nghiên cứu quy mô lớn, việc trả lời RAM bao nhiêu sẽ đẩy ngưỡng lên 64 GB hoặc thậm chí 96 tới 128 GB. Riêng mô hình Llama 3.1 70B Q4_K_M đã chiếm 43,1 GB cho phần trọng số nạp tĩnh. Với mô hình khổng lồ như gpt-oss 120B đòi hỏi 64,0 GB ở ngữ cảnh 8K và lên tới 68,5 GB tại 131K, bạn buộc phải trang bị máy trạm di động cao cấp mới xử lý trọn.
Lượng tử hóa Q4 và Q8 tiết giảm dung lượng ra sao
Lượng tử hóa là kỹ thuật nén trọng số mô hình xuống độ chính xác thấp hơn, nhờ đó giảm mạnh dung lượng chiếm dụng và hạ ngưỡng RAM bao nhiêu bạn phải chuẩn bị. Cùng một mô hình 8B, bản gốc FP16 nặng khoảng 16 GB, trong khi bản Q4_K_M chỉ còn 4,9 GB mà chất lượng suy giảm không đáng kể. Định dạng GGUF của llama.cpp hỗ trợ nhiều mức nén, cho bạn cân đối giữa độ trung thực và khả năng nạp gọn vào bộ nhớ hạn hẹp.
| Định dạng lượng tử | Dung lượng mô hình 8B | Đánh đổi |
|---|---|---|
| FP16 gốc | Khoảng 16 GB | Chất lượng tối đa, nặng nhất |
| Q8_0 | Khoảng 8,5 GB | Gần như giữ nguyên độ trung thực |
| Q4_K_M | Khoảng 4,9 GB | Cân bằng, được ưa chuộng nhất |
| Q4_0 | Khoảng 4,7 GB | Nhẹ nhất, giảm nhẹ độ chính xác |
Bản Q4_K_M được ưa chuộng nhất nhờ dung lượng gọn mà vẫn duy trì mạch lạc trong hầu hết tác vụ đối thoại và trích xuất văn bản. Với laptop 16 GB, đây gần như là lựa chọn bắt buộc để chừa dư địa cho ngữ cảnh và ứng dụng nền. Nếu bạn còn băn khoăn RAM bao nhiêu cho tác vụ lập trình khắt khe, bản Q8_0 chạy trên llama.cpp xứng đáng cân nhắc khi máy có sẵn 32 GB trở lên.
Chọn mức nén càng sâu thì mô hình càng nhẹ, song độ chính xác từng bước suy luận cũng hao hụt phần nào. Bạn nên bám sát dung lượng đang có để chọn định dạng phù hợp, thay vì cố nạp bản FP16 nặng nề rồi rơi vào cảnh tràn bộ nhớ. Cách khôn ngoan là thử bản Q4_K_M trước, đo xem RAM bao nhiêu còn trống, sau đó mới nâng độ chính xác nếu cấu hình dư dả.
Băng thông VRAM và bộ nhớ hệ thống chênh nhau ra sao
Nhiều bạn lầm tưởng gắn thêm bộ nhớ hệ thống sẽ giúp card đồ họa tăng dung lượng bộ nhớ chuyên dụng. Về bản chất, VRAM trên card rời gắn liền chip xử lý đồ họa và sở hữu băng thông cao, chẳng hạn RTX 4060 Laptop 8 GB GDDR6 đạt 256 GB/s cùng sức mạnh trí tuệ nhân tạo 233 TOPS. Khi mô hình nằm trọn trong VRAM, tốc độ suy luận luôn giữ ở ngưỡng cao nhất, và câu hỏi RAM bao nhiêu lúc này nhường chỗ cho dung lượng VRAM khả dụng.
| Loại bộ nhớ | Băng thông | Vai trò khi chạy mô hình |
|---|---|---|
| VRAM GDDR6 (RTX 4060 và 4070 8 GB) | 256 GB/s | Nhanh nhất, chứa trọn mô hình nhỏ |
| LPDDR5X-8533 hàn liền | Khoảng 68 GB/s | Suy luận CPU tốc độ khá |
| DDR5-5600 khe SO-DIMM | Khoảng 44 GB/s | Linh hoạt nâng cấp, chậm hơn |
Nếu mô hình vượt quá 8 GB VRAM, phần mềm tự đẩy phần trọng số dư sang bộ nhớ hệ thống để xử lý qua vi xử lý trung tâm. Card mạnh như RTX 4070 Laptop với 4.608 nhân CUDA và 321 TOPS vẫn bị kìm hãm khi phải chờ dữ liệu truyền qua giao tiếp bộ nhớ chậm hơn. Bài toán cân đối RAM và VRAM cho tác vụ lập trình được phân tích kỹ trong bài Chạy agent code cục bộ với DeepSeek Harness: Laptop cần RAM và VRAM bao nhiêu?
Phân bổ tài nguyên hợp lý giữa VRAM và bộ nhớ hệ thống chính là chìa khóa duy trì hiệu suất bền vững, nên câu hỏi RAM bao nhiêu luôn đi kèm câu hỏi VRAM bao nhiêu. Khi nạp mô hình tạo ảnh hay nhận diện phức tạp, thiếu VRAM sẽ khiến thời gian chờ kéo dài, còn thiếu bộ nhớ hệ thống lại làm ngữ cảnh bị cắt ngắn. Bạn nên xác định trước loại tác vụ chủ đạo để chọn tỷ lệ hai vùng nhớ.
Chuẩn LPDDR5X và DDR5 tác động tốc độ suy luận
Bên cạnh dung lượng, băng thông bộ nhớ cũng chi phối tốc độ suy luận của mô hình khi chạy trên vi xử lý trung tâm. Chuẩn LPDDR5X-8533 hàn liền đem lại băng thông khoảng 68 GB/s, giúp llama.cpp đọc ghi trọng số nhanh hơn. Chuẩn DDR5-5600 dạng khe SO-DIMM tháo rời chỉ đạt khoảng 44 GB/s cùng độ trễ nhỉnh hơn, đổi lại cho bạn khả năng nâng dung lượng về sau.
| Tiêu chí | LPDDR5X-8533 | DDR5-5600 SO-DIMM |
|---|---|---|
| Băng thông | Khoảng 68 GB/s | Khoảng 44 GB/s |
| Khả năng nâng cấp | Hàn chết, chọn đúng từ đầu | Tháo rời, tăng lên 64 GB |
| Điện năng | Tiết kiệm hơn | Cao hơn đôi chút |
Hiệp hội tiêu chuẩn LPDDR6 JESD209-6 đã công bố tốc độ truyền tải 10.667 tới 14.400 MT/s, hứa hẹn nâng tầm băng thông cho các thế hệ vi xử lý kế tiếp. Ở thời điểm hiện tại, LPDDR5X và DDR5 vẫn là hai phương án chủ đạo mà bạn cần cân nhắc giữa tốc độ và khả năng mở rộng.
Nếu ưu tiên tính cơ động cùng tốc độ trích xuất văn bản nhanh, laptop mỏng nhẹ dùng LPDDR5X 32 GB là lựa chọn đáng giá. Trường hợp muốn tiết kiệm chi phí ban đầu rồi nâng lên 64 GB khi có dự án lớn, mẫu máy hai khe DDR5 tháo rời sẽ an toàn hơn, và bạn nên cân nhắc RAM bao nhiêu cho lộ trình chạy mô hình dài hạn.
Chọn cấu hình laptop chạy AI cục bộ hiệu quả
Khi tìm cấu hình laptop để triển khai trí tuệ nhân tạo cục bộ, bạn nên ưu tiên card đồ họa rời từ RTX 4060 8 GB trở lên kết hợp tối thiểu 32 GB bộ nhớ. Trước khi chốt RAM bao nhiêu, hãy hình dung khối lượng mô hình định chạy, vì cấu hình này cho phép nạp lớp tính toán nặng vào VRAM và dùng bộ nhớ hệ thống lớn để lưu trọn ngữ cảnh mà không sụt giảm hiệu năng giữa phiên làm việc dài.
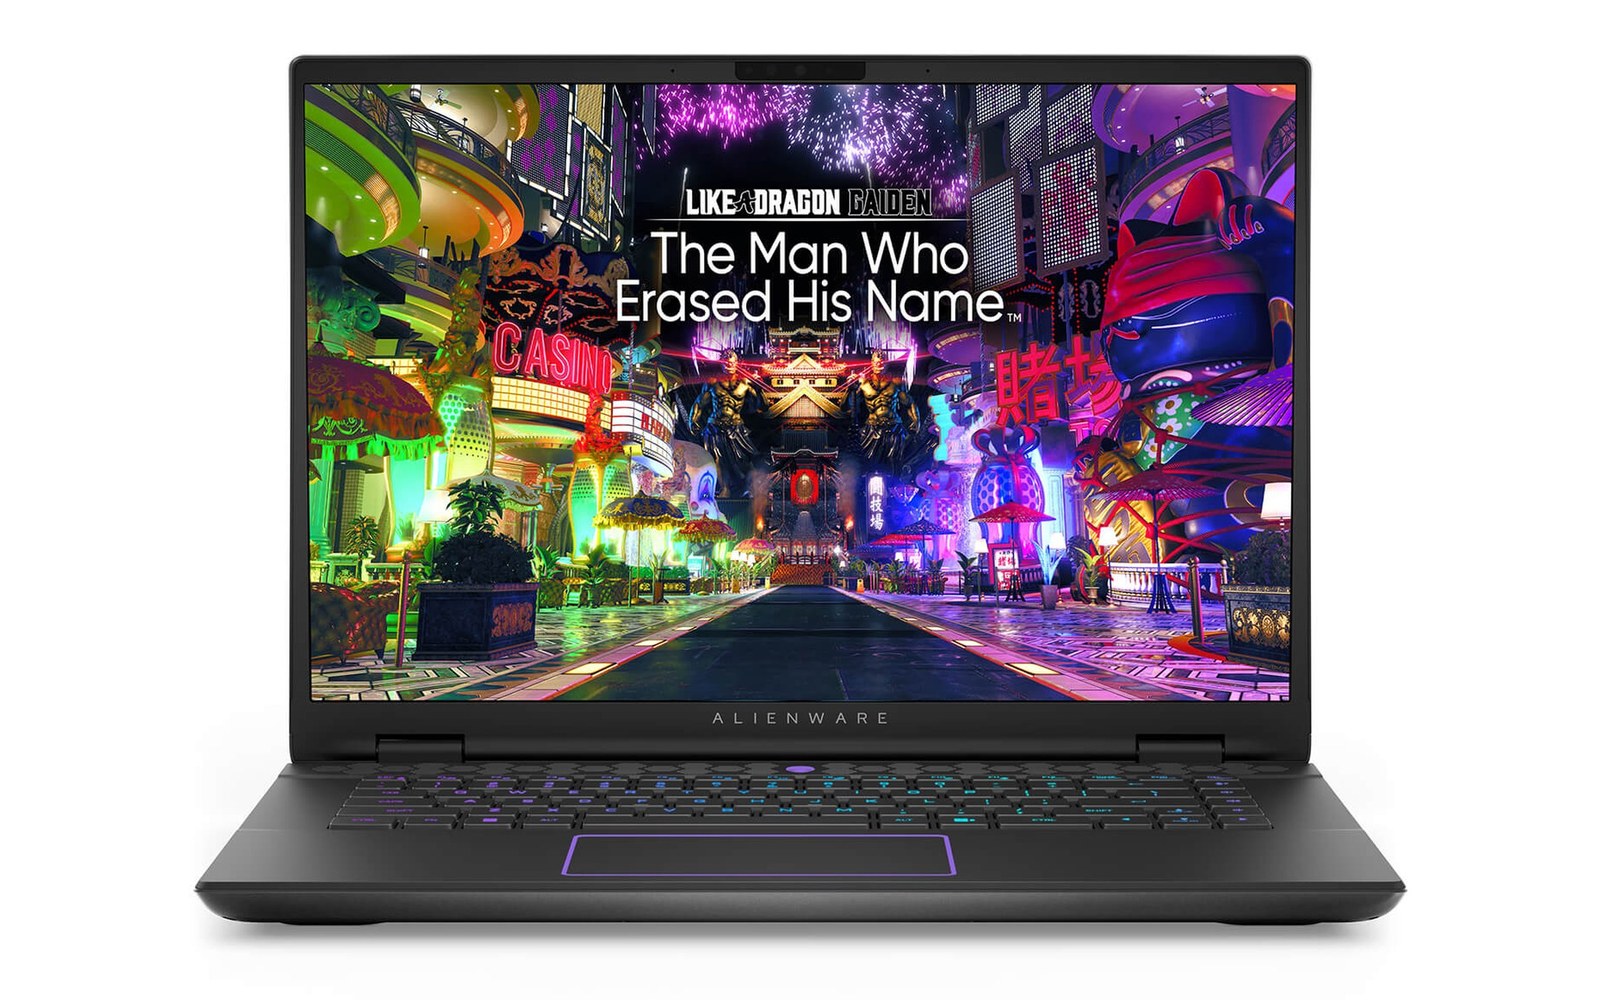
Một lựa chọn mình đánh giá cao là Alienware m16 R2 (2024) với bản Core Ultra 9 185H, 32 GB bộ nhớ và card RTX 4070 8 GB, mức giá dao động tầm 35 tới 51 triệu đồng. Cấu hình này nạp phần lớn mô hình 20B vào 32 GB bộ nhớ hệ thống và dùng 8 GB VRAM để tăng tốc các lớp tính toán, đồng thời giữ trọn ngữ cảnh dài trong RAM, giải tỏa băn khoăn RAM bao nhiêu cho nhóm vừa lập trình vừa thử nghiệm mô hình cỡ trung.
Bạn học tập cơ bản chỉ cần mức 16 GB để làm quen với mô hình 8B; nhóm kỹ thuật, lập trình và sáng tạo nội dung nên đầu tư thẳng lên 32 GB để đạt cân bằng tối ưu; còn nhóm nghiên cứu chuyên sâu nên hướng tới 64 GB trở lên trên nền tảng nâng cấp linh hoạt. Trả lời sớm câu hỏi RAM bao nhiêu ngay từ đầu giúp bạn tránh lãng phí khi phải đổi máy chỉ sau thời gian ngắn.
Câu hỏi thường gặp (FAQ)
Laptop chạy AI cục bộ cần tối thiểu bao nhiêu bộ nhớ?
Mức 32 GB hiện là phương án cân bằng nhất cho đa số nhu cầu làm việc với mô hình ngôn ngữ lớn, và đây cũng là mốc mình khuyên khi bạn hỏi RAM bao nhiêu là đủ. Cấu hình này giúp nạp trọn mô hình 20 tỷ tham số như gpt-oss 20B và duy trì ngữ cảnh tới 131K mà không tràn bộ nhớ. Nếu chỉ học tập cơ bản với mô hình 8B, mức 16 GB đáp ứng được nhưng hạn chế khi xử lý đa nhiệm.
Dung lượng bộ nhớ tối đa lắp được trên laptop hiện nay là bao nhiêu?
Trên máy trạm di động và laptop gaming cao cấp, dung lượng bộ nhớ tối đa hiện đạt từ 64 GB tới 128 GB qua các khe DDR5 SO-DIMM hoặc chuẩn module CAMM2 mới. Mức này cho phép bạn thử nạp trực tiếp mô hình khổng lồ như Llama 3.1 70B hoặc gpt-oss 120B đã qua lượng tử hóa. Chi phí cho cấu hình bộ nhớ cực lớn thường khá cao và chỉ phù hợp nhóm nghiên cứu chuyên nghiệp.
Chi phí nâng cấp bộ nhớ cho laptop chạy AI khoảng bao nhiêu?
Chi phí nâng cấp phụ thuộc vào chuẩn linh kiện và dung lượng bạn muốn bổ sung. Một thanh DDR5-5600 dung lượng 16 GB chính hãng hiện có giá tầm 1,2 tới 1,5 triệu đồng, còn thanh 32 GB dao động tầm 2,5 tới 3,2 triệu đồng. Bạn cần kiểm tra kỹ bo mạch của máy là dạng khe cắm tháo rời hay hàn chết trước khi quyết định RAM bao nhiêu cho lần nâng cấp này.
Băng thông LPDDR5X và DDR5 ảnh hưởng tốc độ sinh từ thế nào?
Băng thông càng cao thì tốc độ đọc trọng số mô hình khi suy luận trên vi xử lý trung tâm càng nhanh, giúp tăng số từ tạo ra mỗi giây. Chuẩn LPDDR5X-8533 cung cấp khoảng 68 GB/s, nhỉnh hơn mức 44 GB/s của DDR5-5600 tiêu chuẩn. Điểm cần lưu ý là dòng máy dùng LPDDR5X thường hàn chết linh kiện, buộc bạn chọn đúng dung lượng 32 GB ngay từ thời điểm mua ban đầu.

0 phản hồi cho “Chạy mô hình 8B qua llama.cpp – Cần RAM bao nhiêu để giữ ngữ cảnh”